Americký vedec Nick Cammarata prišiel s prevratnou tézou: systémy umelej inteligencie s miliardami parametrov v skutočnosti nie sú záhadnými čiernymi skrinkami, za aké ich už dlho všeobecne považujeme a za aké ich radi označujú aj šéfovia dvoch najväčších svetových AI laboratórií. Podľa neho sú celkom dobre čitateľné. Čím svoje tvrdenie podkladá? A má pravdu?
Len sa na logiku ich fungovania musíme pozerať inak, než sme boli doteraz zvyknutí. Ak má Cammarata pravdu, znamenalo by to okrem iného, že umelú inteligenciu dokážeme úspešne riadiť a zosúladiť s ľudskými záujmami.
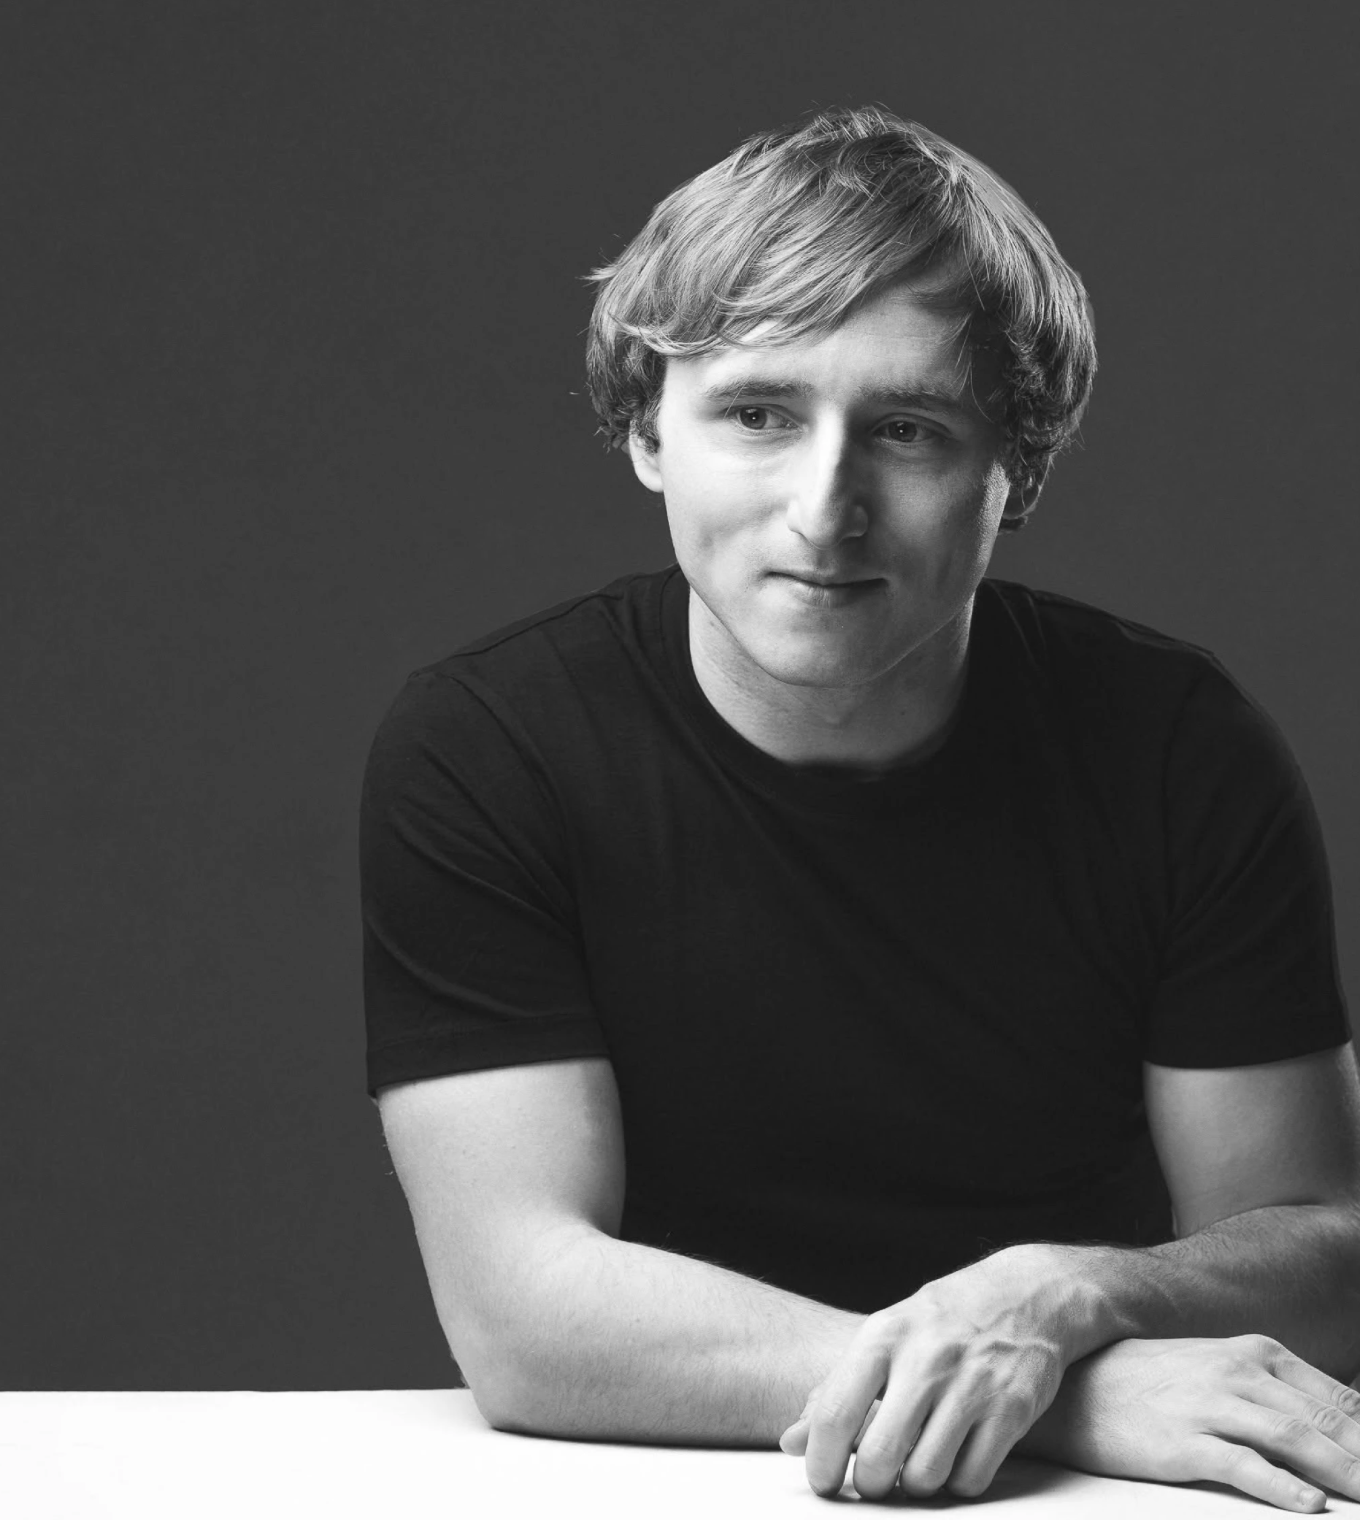
Ak neviete, kam si meno Nicka Cammaratu zaradiť, no predsa len vám je odniekiaľ povedomé, vedzte, že ide o významného bývalého výskumníka neurónových sietí zo spoločnosti OpenAI. V roku 2023 sa rozhodol vydať sa vlastnou cestou a dnes sa v AI startupe Goodfire venuje výskumu interpretovateľnosti veľkých jazykových modelov a neurónových sietí.
Cammaratova spoločnosť sa priamo usiluje vytvoriť komerčný systém nástrojov určený na interpretáciu a úpravu vnútorných reprezentácií jednotlivých modelov umelej inteligencie. Investori si ju napriek veľmi krátkej histórii už cenia na 1,25 miliardy dolárov, teda približne 1,08 miliardy eur.
Nick Cammarata na seba teraz upozornil publikovaním eseje s rozsahom 26-tisíc slov a názvom Neurónové siete sú už čisté. Zjednodušene povedané, tvrdí v nej a pokúša sa dokázať, že celá komunita AI sa doteraz na fungovanie neurónových sietí pozerala nesprávne a ľudia v skutočnosti dokážu pochopiť, ako umelá inteligencia uvažuje.
Esej vzbudila pozornosť viacerých Cammaratových kolegov, zakladateľov firiem a investorov zo Silicon Valley. Uznania sa jej dostalo dokonca aj od šéfa OpenAI Sama Altmana. Podľa prestížneho časopisu MIT Technology Review ide o moment, ktorý môže zmeniť dejiny. Teda za predpokladu, že sa celá téza potvrdí.
Podstata je v tom, že ak skutočne dokážeme interpretovať logiku, podľa ktorej modely umelej inteligencie uvažujú, môžeme do nich zároveň zaviesť mechanizmy, ktoré ich zosúladia s ľudskými záujmami a bezpečnosťou.
Dokážeme tiež pochopiť, prečo veľké jazykové modely tak rady obchádzajú svoje obmedzenia, prečo používateľom hovoria nebezpečné veci a prečo AI agenti robia aj to, na čo ich nikto neinštruoval. Alebo prečo na zdanlivo jednoznačnú požiadavku generujú nezmyselné, surrealistické výstupy, ako sa to nedávno podarilo donáškovej spoločnosti Just Eat.
A v neposlednom rade by sme mohli brať na zodpovednosť aj AI laboratóriá, ktoré dnes tak rady používajú nezrozumiteľnosť správania umelej inteligencie ako výhovorku, aby sa vyhli akejkoľvek zodpovednosti.
Prečo sme neurónové siete považovali za nečitateľné
Vo svojej rozsiahlej eseji, publikovanej priamo na stránkach Goodfire, Cammarata tvrdí, že sme celý čas nesprávne chápali spleť neurónových sietí, teda mechanizmus, na ktorom stoja dnešné veľké jazykové modely.
Samotný fakt, že modely počas tréningu vytvárajú zvláštne a navzájom prepojené štruktúry, ktoré z ľudského pohľadu nedávajú vnútorný zmysel, podľa vedca ešte neznamená, že sú skutočne nečitateľné.
Väčšina súčasných výskumníkov umelej inteligencie sa s touto zdanlivou nečitateľnosťou zmierila. Dnes sa často uspokojujú s názorom, že neurónové siete nemožno interpretovať. Trénovanie modelov potom prirovnávajú skôr k pestovaniu veľkého organického celku, napríklad lesa či záhrady, než k stavbe domu alebo automobilu.
Paradoxne, k presadeniu tohto pohľadu výrazne prispel sám Cammarata. Keď pracoval v OpenAI, stál pri zrode prvých priekopníckych techník, ktoré sa pokúšali nahliadnuť do vnútra modelov. Využívali napríklad nástroje skúmajúce jednotlivé umelé neuróny a zisťujúce, čo presne reprezentujú.
V roku 2020 si Cammarata so svojimi kolegami pri malom modeli Inception v1, vytrénovanom na rozpoznávanie obrazov, všimli, že jednotlivé neuróny často zachytávajú viacero rôznych, na prvý pohľad nesúvisiacich vecí. Jeden neurón napríklad reagoval na obrázky automobilov, ale aj psov.
Z logického hľadiska to nedávalo zmysel. Vedci dospeli k záveru, že model sa snaží čo najlepšie využiť svoju kapacitu tým, že niekedy používa rovnaké neuróny na plnenie viacerých úloh. Za rovnakých podmienok tak dokáže spracovať viac dát.
Rovnaký záhadný jav, pri ktorom modely ukladajú úplne nesúvisiace koncepty do tých istých neurónov, neskôr potvrdili aj ďalší výskumníci. Postupne sa preň ujal názov prevzatý z kvantovej mechaniky – takzvaná superpozícia. Označuje stav, keď sa jedna vec nachádza v rovnakom okamihu vo viacerých stavoch.
Väčšina výskumníkov umelej inteligencie z toho vyvodila záver, že pri pohľade do vnútra modelu uvidíme len neprehľadnú a nepochopiteľnú zmes zvláštne prepojených javov a prvkov.
Dnešné popredné jazykové modely sú pritom ešte oveľa komplikovanejšie a rozsiahlejšie. Zatiaľ dokážeme nahliadnuť a porozumieť len nepatrnej časti ich fungovania. Hlasnejšiu časť odbornej komunity v oblasti umelej inteligencie to priviedlo k trochu nihilistickému záveru, že veľkým jazykovým modelom možno nikdy úplne neporozumieme. Istý čas k nej patril dokonca aj Cammarata.
Lenže sa s tým nedokázal zmieriť a nikdy sa neprestal usilovať modelom porozumieť. Dnes tvrdí, že superpozícia v skutočnosti možno vôbec nie je takým problémom, ako sa zdalo. To, čo na nej má byť nepochopiteľné, je podľa jeho tézy len dôsledkom iných, menej zásadných problémov.
Patria medzi ne predovšetkým nedokonalé architektúry neurónových sietí, rovnako nedokonalé nástroje, ktoré používame na ich interpretáciu, ale aj nesprávne predpoklady výskumníkov o tom, čo presne majú neuróny reprezentovať, a veľmi obmedzené chápanie toho, ako neuróny zovšeobecňujú.
Superpozícia nemusí byť tým, za čo sme ju považovali
Zjednodušene povedané, nejde o to, či superpozícia existuje, alebo nie. Cammarata jej existenciu nespochybňuje. Tvrdí však, že výskumníci umelej inteligencie doterajšie dôkazy interpretovali nesprávne a že superpozícia možno nie je univerzálnym princípom, ktorý definuje fungovanie modelov.
Zdanlivo nesúvisiace funkcie jednotlivých neurónov sa podľa neho dajú vysvetliť niečím, čo nazýva rekurzívnym zovšeobecňovaním.
Predstavme si napríklad situáciu, keď neurón najskôr reaguje na malú skupinu znakov, no počas tréningu postupne rozširuje svoju funkciu. Spočiatku reaguje iba na sekvenciu znakov „iy“, neskôr do svojho záberu zahrnie aj „diy“ a napokon sa jeho aktivita rozšíri aj na výraz „do it yourself“.
Hoci to pri pohľade zvonka môže vyzerať ako nesúrodá zmes niekoľkých nesúvisiacich funkcií, v skutočnosti to môže znamenať len to, že model postupne rozvíja vzorce, ktoré sa počas tréningu naučil a ktoré spolu súvisia.
Takto by sme podľa Cammaratu mohli vysvetliť aj zdanlivo nesúvisiace situácie, keď neurón reaguje na automobily, ale aj na psy či mačky. Všetky tieto objekty majú totiž v prednej časti „oči a ňufák“.
Rekurzívne zovšeobecňovanie je podľa Cammaratu oveľa menej znepokojujúce než predstava superpozície. Dôvodom je, že spôsob, akým sieť zoskupuje koncepty, už nepredstavuje niečo, čomu nedokážeme porozumieť. Naopak, odhaľuje, ako sa sieť naučila zovšeobecňovať.
Kým superpozícia predstavovala prekážku, rekurzívne zovšeobecňovanie môže byť kľúčom k pochopeniu vnútorného fungovania modelu. To by znamenalo zásadné prehodnotenie starších vedeckých štúdií o fungovaní neurónových sietí a naznačovalo by, že v skutočnosti sú oveľa čitateľnejšie, než sme si doteraz mysleli.
Väčšie modely môžu byť paradoxne čitateľnejšie
Svoju tézu Cammarata dokladá skúmaním modelu Inception v1, pričom porovnáva výsledky dosiahnuté v minulosti so súčasnými nástrojmi a lepšími metódami. Tvrdí, že sa mu týmto spôsobom podarilo umožniť interpretáciu 99 až sto percent neurónov v poslednej vrstve upraveného modelu. Uvádza aj niekoľko sľubných predbežných výsledkov z auditu súčasných veľkých jazykových modelov.
Je tu však ešte jedna dôležitá vec. Cammarata tvrdí, že veľkosť modelu nemusí zhoršovať jeho interpretovateľnosť, ako sa doteraz predpokladalo. Za určitých podmienok ju môže, naopak, uľahčovať.
S rastúcou kapacitou sa totiž môžu všeobecné reprezentácie rozpadávať na špecializovanejšie a ľahšie rozpoznateľné časti. Výsledkom môže byť prehľadnejšia hierarchia, v ktorej majú jednotlivé komponenty pomerne jasné funkcie a ich vzájomné vzťahy sa dajú postupne zmapovať.
Tento efekt prirovnáva k mestu. V malom meste neexistuje finančná štvrť a odmyslime si teraz fakt, že ju nemá ani množstvo veľkých európskych miest. Banka, audítorská firma a poisťovňa sú preto rozmiestnené pomerne náhodne. Vo veľkom meste je však pravdepodobnejšie, že takáto štvrť vznikne, a každý ju dokáže pomerne ľahko identifikovať na mape.
Nie všetci odborníci sú presvedčení
Samozrejme, Cammaratova téza nepresvedčila všetkých výskumníkov umelej inteligencie. Neel Nanda z Google DeepMind, ktorý v spoločnosti Google vedie tím zameraný na mechanistickú interpretovateľnosť neurónových sietí, napríklad na sociálnej sieti X tvrdí, že nejde o žiadny zásadný posun v celkovom chápaní interpretovateľnosti. Naďalej je tiež presvedčený, že superpozícia existuje.
Otázkou zostáva aj to, či poznanie funkcie jednotlivých neurónov skutočne umožňuje predvídať, ako fungujú ako celok. To je však napokon odvekým cieľom vedy: niekto sa musí pokúsiť Cammaratove tézy vyvrátiť.
Zatiaľ sme len na úplnom začiatku.
Článok vyšiel na forbes.cz.